USKMaker — UltraStar Karaoke Maker



🇬🇧 English version
Gerador de pacotes de karaokê UltraStar a partir de um link do YouTube ou de um arquivo de áudio local, com sincronização de letra, extração de pitch, detecção de BPM e metadados (capa, ano, gênero) automáticos.
O diferencial em relação a ferramentas como o UltraSinger é que o USKMaker parte da letra que o usuário já fornece. O problema passa a ser de forced alignment (alinhar uma letra conhecida ao áudio), não de transcrição do zero — o que resulta em sincronização bem mais precisa, especialmente em português.
Todo o processamento é local: não depende de APIs pagas nem envia áudio para serviços externos. As únicas consultas de rede são a bancos abertos e gratuitos (MusicBrainz/Cover Art Archive, iTunes, Deezer e — opcionalmente, com token pessoal — Discogs) para enriquecer metadados, e o download do YouTube quando solicitado.
Como funciona
O pipeline tem seis etapas:
- Obter áudio — baixa do YouTube (via
yt-dlp) ou normaliza um arquivo local para WAV. Opcionalmente baixa também o vídeo, para fundo animado no jogo.
- Separação vocal — isola voz e instrumental com Demucs (
htdemucs).
- Detecção de BPM — estima o andamento com librosa.
- Alinhamento letra-áudio — alinhamento acústico global direto (CTC / MMS / wav2vec2): a letra fornecida inteira é alinhada contra a faixa vocal em uma única passagem rápida, garantindo a ordem exata das frases (com modelos acústicos dedicados por idioma, como wav2vec2 sueco). Linhas com baixa confiança são sinalizadas para conferência, e o alinhamento clássico via WhisperX + âncoras acústicas/fuzzy atua automaticamente como fallback caso a confiança geral seja baixa. Quando a letra vem sincronizada do LRCLIB (
.lrc) ou de arquivo aprovado, os tempos de início de linha entram como âncoras fixas. Letras em alfabetos não latinos mantêm o alinhamento via WhisperX automaticamente.
- Metadados — busca capa, ano e gênero em cascata, cada fonte preenchendo só o que ainda falta: tags embutidas no arquivo → MusicBrainz + Cover Art Archive (priorizando álbuns originais de estúdio sobre coletâneas) → iTunes (capa 600x600, ano e gênero) → Deezer (capa 1000px) → Last.fm (capa e gênero; opcional: defina
LASTFM_API_KEY com uma chave gratuita) → Discogs (opcional: defina DISCOGS_TOKEN com um token pessoal gratuito). As fontes opcionais são puladas quando a variável correspondente não existe. Para a imagem de fundo (#BACKGROUND, 16:9): se FANARTTV_API_KEY estiver definida (chave pessoal gratuita em fanart.tv), busca um artist background real; sem a chave ou sem arte, o fundo reaproveita a capa como [BG].jpg — assim todo pacote com capa tem #BACKGROUND.
- Montagem — extrai o pitch por sílaba (SwiftF0 em janelas otimizadas), separa sílabas com regras específicas do idioma (português, inglês, sueco via pyphen), posiciona as sílabas exatamente onde cada fonema foi cantado, calibra notas sustentadas acompanhando a voz, marca automaticamente as notas mais longas como douradas (
*, bônus de pontuação, ~5% das notas — padrão calibrado em charts feitos à mão) e monta o arquivo .txt no formato UltraStar, com áudio convertido para .ogg ou .mp3.
Stack
- Interface: Tauri v2 + React 18 + TypeScript + Vite — bilíngue (PT-BR/EN, detecta o idioma do sistema e pode ser trocada a qualquer momento no cabeçalho)
- Núcleo de escrita do formato: Rust (
rust-core, crate uskmaker_core)
- Pipeline de IA: Python (sidecar), com WhisperX, Demucs, librosa, SwiftF0, pyphen
- Arquitetura: o frontend chama o Rust (Tauri), que invoca o sidecar Python; o Python exporta um JSON intermediário (
song_data.json) e o Rust é quem escreve o .txt final a partir dele.
Requisitos
- Python 3.12 (testado com 3.12.10)
- GPU NVIDIA com CUDA — desenvolvido e testado numa RTX 4060 (8 GB VRAM). No Linux, GPUs AMD também funcionam, via ROCm (testado numa RX 7800 XT). Roda em CPU, mas a separação vocal e o alinhamento ficam bem mais lentos.
- Node.js e Rust (toolchain estável), para a parte Tauri.
- ffmpeg com suporte a
libvorbis (para gerar .ogg). Pelo instalador do Windows (Opção A) ele é baixado automaticamente pelo setup-sidecar.ps1; no Linux ele vem da distribuição (o .deb/.rpm já o instalam); no modo desenvolvimento, tenha-o no PATH.
Instalação
Opção A (Windows) — WinGet ou Instalador (recomendado para uso)
Instale direto pelo terminal via Windows Package Manager (WinGet):
winget install walterfr.USKMaker
Ou baixe o instalador manualmente:
- Baixe o instalador (
USKMaker_x.y.z_x64-setup.exe) na página de Releases e instale normalmente.
- Abra o USKMaker e clique em "Configurar ambiente de IA". Ele baixa o Python 3.12 (via
uv), um ffmpeg embutido (com libvorbis) e as bibliotecas de IA automaticamente, com progresso ao vivo (≈ 10–15 min na primeira vez, ~2 GB, requer internet).
- Pronto, é só usar. Na primeira música, os modelos de IA são baixados automaticamente (~2 GB, só na primeira vez).
Requisitos: Windows 10/11 e (opcional, mas muito recomendado) GPU NVIDIA — sem ela o processamento roda em CPU, ~10 min por música. Python e ffmpeg não precisam ser instalados à mão — o botão cuida disso.
> Usuários avançados (setup manual): o botão não é obrigatório. Você pode configurar o ambiente você mesmo de duas formas: (a) rodar o setup-sidecar.ps1 da pasta de instalação diretamente (clique-direito → "Executar com PowerShell" — faz o mesmo que o botão, pelo terminal); ou (b) montar tudo à mão com o seu próprio Python, como na Opção B abaixo (crie o venv em %LOCALAPPDATA%\USKMaker\venv). O app também respeita um ffmpeg já presente no PATH e um venv que você tenha criado manualmente.
Opção A (Linux) — .deb, .rpm ou AppImage
- Baixe o pacote da sua distribuição na página de Releases:
- Debian / Ubuntu / Mint:
sudo apt install ./USKMaker_x.y.z_amd64.deb
- Fedora / openSUSE:
sudo dnf install ./USKMaker-x.y.z-1.x86_64.rpm
- Qualquer distribuição: o
.AppImage — chmod +x USKMaker_x.y.z_amd64.AppImage e execute.
- Instale um compilador C e o ffmpeg, se ainda não tiver (o
.deb/.rpm já trazem o ffmpeg). O compilador monta uma das bibliotecas de IA durante o setup.
- Fedora:
sudo dnf install gcc ffmpeg-free (o ffmpeg-free do próprio Fedora basta — ele tem libvorbis)
- Debian/Ubuntu:
sudo apt install build-essential ffmpeg
- Arch:
sudo pacman -S base-devel ffmpeg
- Abra o USKMaker e clique em "Configurar ambiente de IA", como no Windows. Ele roda o
setup-sidecar.sh, que baixa o Python 3.12 (via uv) e as bibliotecas de IA em ~/.local/share/USKMaker — nada é instalado no sistema e ele nunca pede sudo. Ele escolhe o PyTorch da sua GPU: CUDA na NVIDIA, ROCm na AMD (exige /dev/kfd, ou seja, o driver amdgpu), CPU nos demais casos.
O script confere o compilador e o ffmpeg antes de tudo e, se faltar algum, mostra o comando de instalação da sua distribuição. Para rodá-lo num terminal em vez do botão: bash /usr/lib/USKMaker/_up_/scripts/setup-sidecar.sh (.deb/.rpm), ou bash scripts/setup-sidecar.sh a partir do repositório.
Opção B — Ambiente de desenvolvimento
1. Sidecar Python
cd python-sidecar
python -m venv venv
.\venv\Scripts\Activate.ps1
python -m pip install --upgrade pip
pip install torch torchaudio torchvision --index-url https://download.pytorch.org/whl/cu126
pip install -r requirements.txt
python -c "import torch; print('CUDA:', torch.cuda.is_available())"
Se CUDA retornar False, revise o driver/versão CUDA antes de continuar (o pipeline foi pensado para rodar em GPU).
> Nota: o WhisperX baixa modelos na primeira execução e pode pedir um token do Hugging Face. Configure-o via variável de ambiente HF_TOKEN ou pelo login do huggingface-cli. Nunca coloque o token dentro do código.
No Linux os passos são os mesmos, com python3.12 -m venv venv e source venv/bin/activate; escolha o índice do PyTorch da sua GPU — cu126 para NVIDIA, rocm6.4 para AMD, cpu sem GPU.
2. App Tauri
npm install
npm run tauri dev
Uso
- Escolha a fonte: link do YouTube ou arquivo de áudio local. No modo arquivo local, você pode opcionalmente baixar um videoclipe do YouTube só para o fundo (
#VIDEO) — o áudio do pacote continua sendo o seu arquivo (útil para coleções ripadas de CD, com qualidade melhor que a do YouTube). Informe o link do clipe ou deixe em branco para busca automática por artista + título; se nenhum vídeo for encontrado, o pacote sai só com a capa.
- Preencha título, artista e idioma (o app confere a letra offline e avisa se o texto parecer de outro idioma, com botão para trocar com 1 clique; no modo arquivo local, título e artista são pré-preenchidos automaticamente a partir das tags do arquivo — só os campos que você ainda não digitou; confira antes de gerar). O BPM é opcional (detectado automaticamente se em branco; a detecção corrige o erro comum de "meio/dobro" do andamento).
- Cole a letra — uma linha por frase cantada. Repita refrões por extenso, tantas vezes quantas forem cantados (não use "(2x)"); caso contrário, as repetições ficam sem notas. Ou clique em Buscar letra (LRCLIB) para preencher automaticamente pelo título + artista informados acima (banco aberto e gratuito); quando há versão sincronizada, os tempos das linhas ainda ajudam o alinhamento.
- Dueto: marque Dueto (duas vozes) e, na letra, comece as linhas de cada cantor com uma tag —
P1:, P2: ou P1&P2: (quando cantam juntos). Uma linha sem tag continua com o cantor da anterior. O pacote sai no formato de dueto da comunidade: headers #P1/#P2 (nomes derivados do artista, ex.: "Elton John & Kiki Dee"), corpo em dois blocos P1/P2 e sufixo [DUET] no arquivo.
- Ajuste as opções desejadas:
- Formato de áudio: escolha entre OGG (padrão) e MP3.
- Resolução de vídeo: limite o vídeo baixado (padrão 1080p para evitar arquivos desnecessariamente pesados).
- Manter backing vocals: isola apenas o vocal principal e preserva coros e harmonias no áudio instrumental (requer opção Backtrack ativa).
- Cookies do YouTube: para vídeos restritos que exigem login ("Sign in to confirm you're not a bot"), ative a opção e aponte o navegador em que você está logado.
- Escolha a pasta de saída e gere — o pacote é criado numa subpasta
Artista - Título (padrão das coleções UltraStar; aponte para a pasta Songs do jogo e pronto). Para processar várias músicas de uma vez, use + Adicionar à fila e depois Gerar fila: elas são processadas em série sem reabrir o app, com os modelos de IA já carregados (da 2ª música em diante o alinhamento é bem mais rápido). Marque "Deixar só o essencial" para que, ao fim da fila, os arquivos auxiliares (.lrc, .log, .json) sejam apagados de cada pasta — o pacote fica enxuto, mas sem a tela de revisão (o song_data.json, que ela lê, é removido).
O pacote resultante contém o .txt UltraStar, o áudio .ogg/.mp3, a capa [CO].jpg (quando encontrada) e, se solicitado, o vídeo .mp4. Pode ser carregado no UltraStar Deluxe, UltraStar Play ou Vocaluxe.
Vídeo de karaokê (opcional): marque Gerar vídeo de karaokê (.mp4) para sair também um Artista - Título (Karaoke).mp4 — a letra preenchendo sílaba a sílaba por cima do fundo, exatamente no tempo que o alinhamento já mediu. Toca em qualquer TV, celular ou pendrive, sem o jogo instalado. O fundo é o vídeo do pacote (quando há), senão a arte de fundo ou a capa; o áudio é o mesmo do pacote, então Backtrack (instrumental) e transposição valem automaticamente. A renderização roda por último e não é fatal: se falhar, o pacote UltraStar continua completo. O arquivo de legenda usado fica na pasta como _karaoke_subs.ass, então dá para mexer no visual e re-renderizar em segundos pela tela de revisão sem rodar a IA de novo.
- (Opcional) Clique em Revisar alinhamento ao final — ou em "Revisar um pacote já gerado..." na tela inicial — para abrir o editor de revisão integrado:
- Ouça a música (mix completo ou só o vocal isolado).
- Arraste notas no tempo/pitch, divida sílabas, ajuste quebras de frase e altere o GAP global.
- Referência de tom via piano roll e edição de notas em lote (Normal, Golden, Freestyle, Rap).
- 🎤 Cantar junto: ligue o microfone (atalho
M) para desenhar sua voz em tempo real sobre as notas e testar a afinação na hora.
- Salve com segurança: alterações nunca são perdidas em caso de erro, e gerar novamente cria backup
.bak automático.
Estado do projeto
Funcional de ponta a ponta pela interface gráfica. Todas as etapas de escopo estão concluídas:
- Pipeline Python — geração de pacotes jogáveis validada com músicas reais.
- Núcleo em Rust — escrita do
.txt com saída idêntica à do protótipo Python, coberta por testes.
- Integração Tauri + UI — fluxo completo pela interface: checagem de ambiente na abertura (IA/ffmpeg/GPU), validação da letra em tempo real (detecta "(2x)", "[Refrão]", timestamps .lrc antes de gastar GPU), lista de etapas com estado e duração típica, botão de cancelar que encerra a árvore de processos, log técnico colapsado e resultado com capa, metadados e contagem de notas por confiança. Preferências e janela persistem entre sessões.
- Metadados e vídeo — título/artista pré-preenchidos das tags do arquivo; capa/ano/gênero automáticos (fonte local e rede); imagem de fundo
#BACKGROUND (fanart.tv opcional, com fallback da capa) e vídeo do YouTube opcional no pacote.
- Distribuição — instalador NSIS no Windows,
.deb/.rpm/AppImage no Linux, mais o setup assistido do ambiente de IA (setup-sidecar.ps1 / setup-sidecar.sh).
- Revisão manual — editor estilo Yass integrado: timeline com waveform, playback (mix ou só vocal), ajuste de notas por arrastar/teclado, quebras de frase, GAP global e undo/redo; salvar regrava o
song_data.json e regenera o .txt pelo núcleo Rust.
Apoie o projeto
O USKMaker é gratuito e de código aberto. Se ele te ajudou, considere apoiar o desenvolvimento — qualquer contribuição ajuda a manter e melhorar o projeto:
Pix (Brasil)
Escaneie o QR code no app do seu banco, ou use a chave copia e cola abaixo:
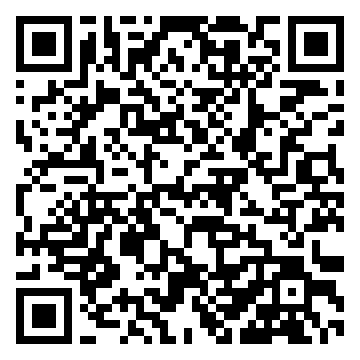
00020101021126400014br.gov.bcb.pix0118walterfr@gmail.com5204000053039865802BR5915WALTER REBOUCAS6009FORTALEZA62070503***63045603
Histórico de versões
O que mudou em cada versão está no CHANGELOG. Os instaladores ficam em Releases.
Licença
MIT. Veja o arquivo LICENSE.
Créditos
Apoia-se em: WhisperX, Demucs, librosa, SwiftF0, yt-dlp, Tauri, MusicBrainz, Cover Art Archive, iTunes Search API, Deezer API, Last.fm e Discogs. Inspiração de fluxo: UltraSinger.
Made with ♥ in Fortaleza-CE, Brazil by @prof.walterfr